PagedAttention:分页内存管理 — Block Manager + PagedAttention
为什么需要这一步?连续分配的碎片问题
在前面的调度器实现中,每个请求进入系统时,KV Cache 采用连续分配策略:引擎在显存里预留一段连续空间,大小为 max_new_tokens(最大生成长度)。这带来了严重的显存浪费。
用具体数字说明:
假设:total_kv_slots = 400,8个并发请求

连续分配策略
────────────────────────────────────────────────
每请求预留 max_len = 50 slots(不管实际生成多长)
8 个请求共占用:50 × 8 = 400 slots  ← 显存全满,无法接新请求

实际使用情况(假设平均生成 30 tokens):
  请求A:用了 28 slots,浪费 22
  请求B:用了 31 slots,浪费 19
  请求C:用了 25 slots,浪费 25
  ...
实际利用率:30 × 8 / 400 = 60%

问题:剩余的 40% 碎片散落在各请求的预留区末尾
      拼不起来,新请求进不来
更极端的情况:如果用户设置 max_new_tokens=512,而模型平均只生成 50 个 token,利用率会跌到约 10%,其余 90% 显存名义上被"占用"却没有存放任何有效数据。
根本原因:连续分配在请求开始时就锁死了空间,而实际需要多少只有生成结束后才知道。
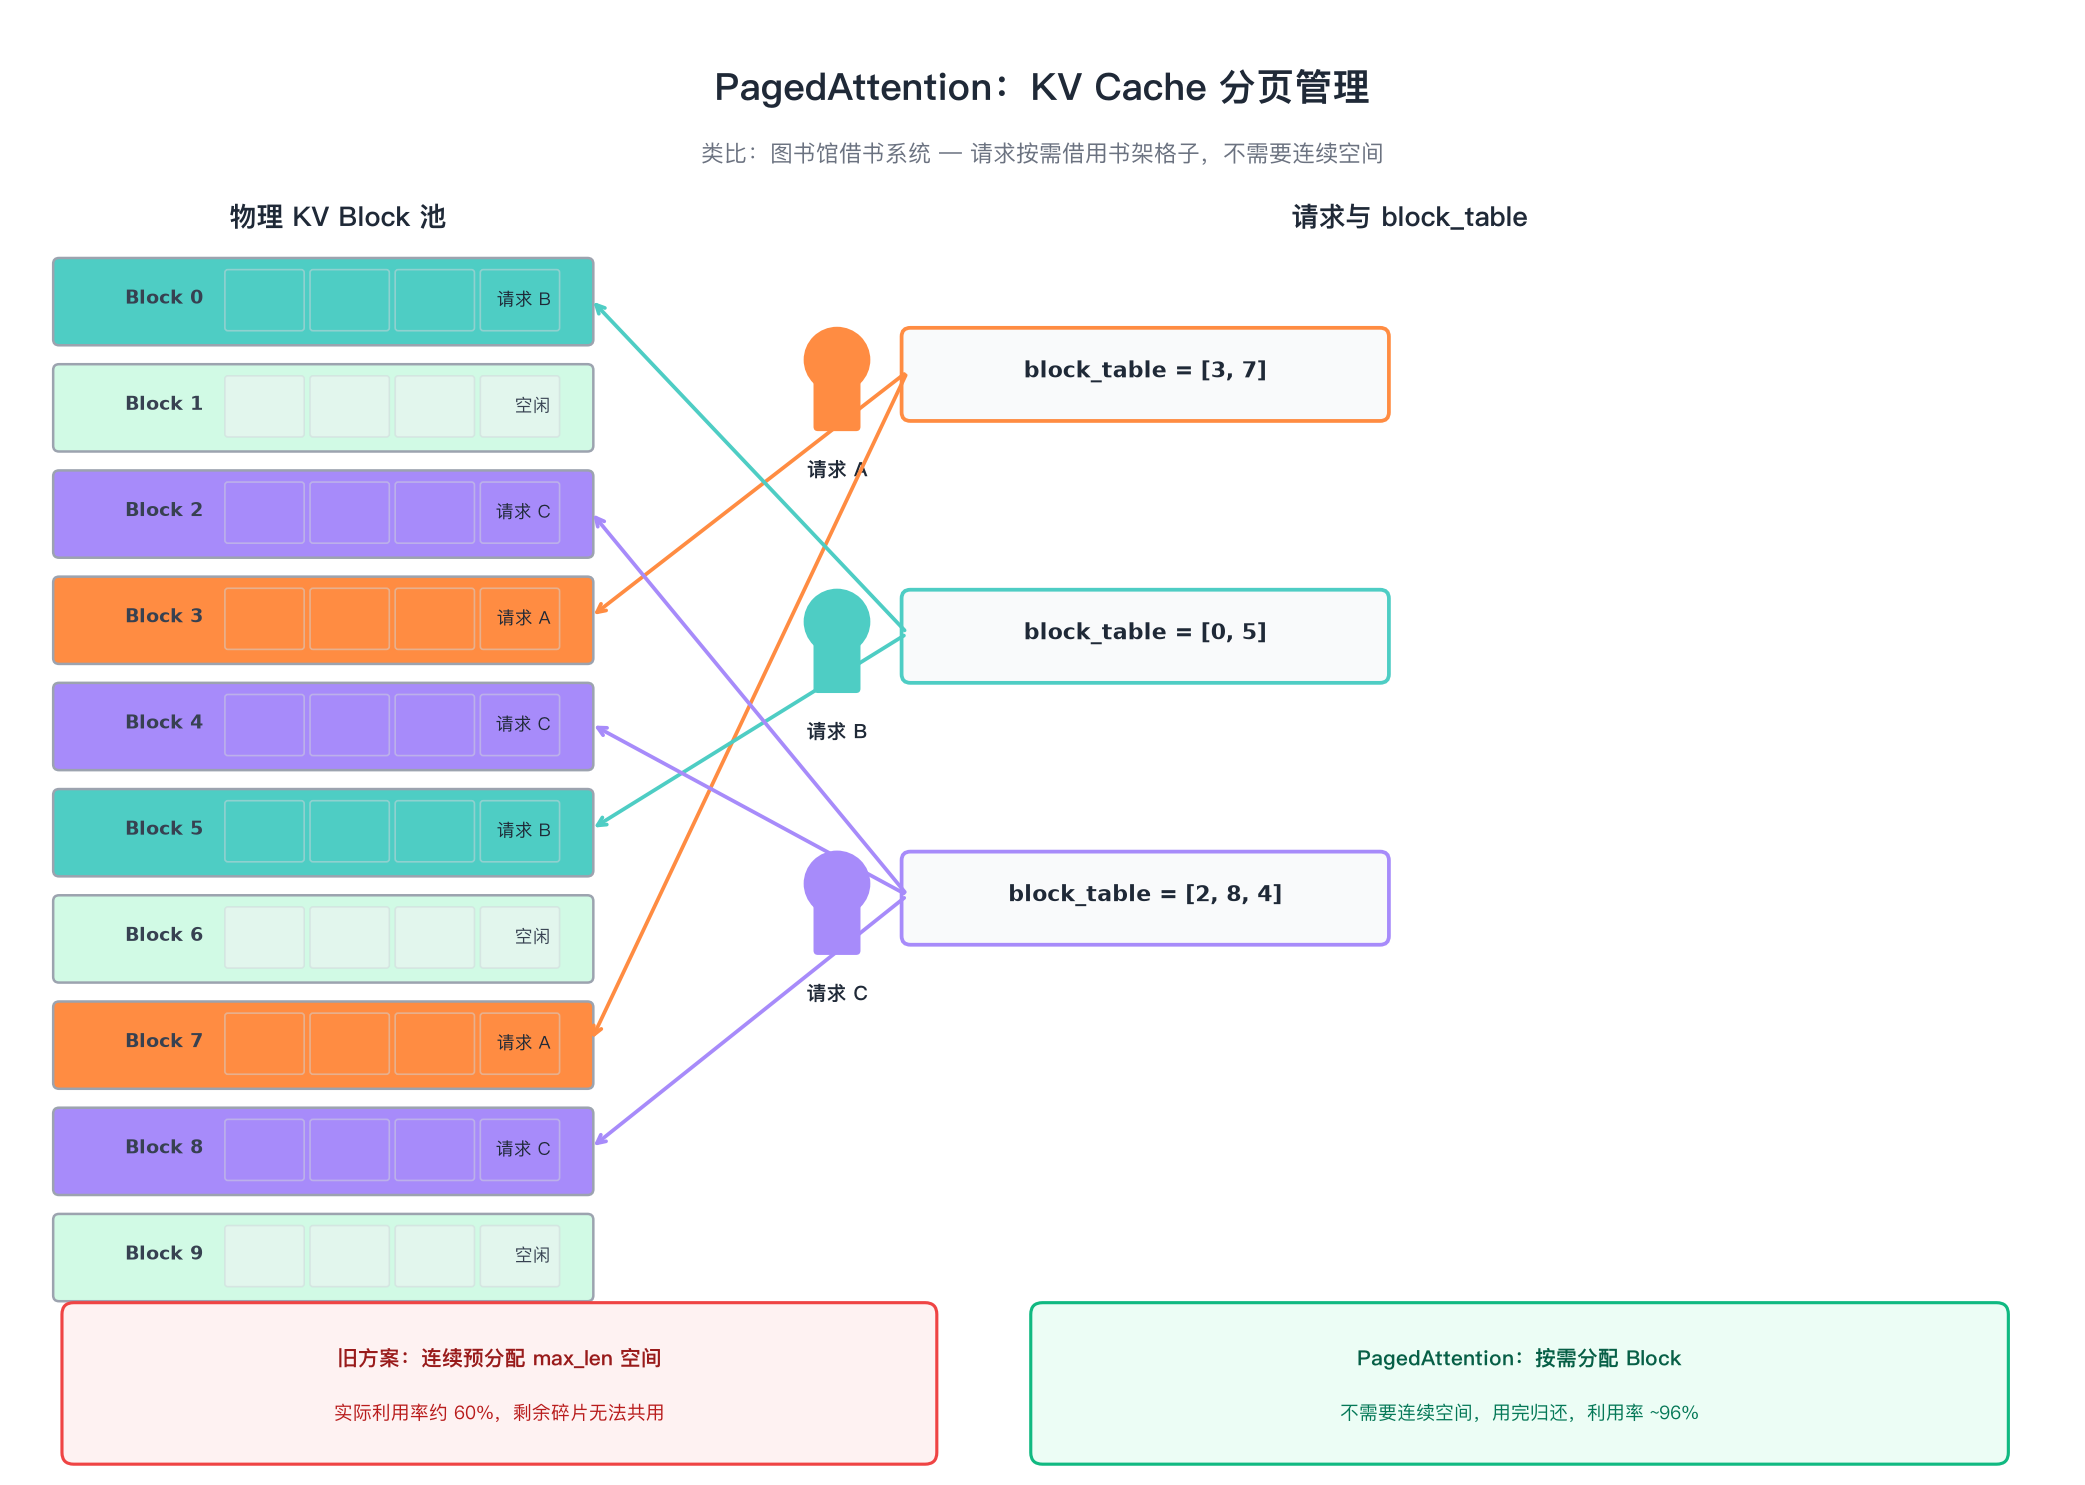
PagedAttention 的解法:借鉴操作系统虚拟内存的分页思想,把 KV Cache 切成固定大小的 Block,按需动态分配,Block 不需要连续。
OS 虚拟内存分页的类比
操作系统面对同样的碎片问题(进程需要连续内存,而物理内存是碎的),解决方案是虚拟地址空间:进程看到的是连续的虚拟地址,OS 用页表(page table)将其映射到分散的物理页帧。
PagedAttention 完全照搬这套设计:
操作系统虚拟内存                    PagedAttention KV Cache
──────────────────────────         ──────────────────────────────────
物理内存页帧 (通常 4KB)       ←→   KV Block(存 block_size 个 token 的 K/V 向量)
虚拟地址 (进程视角连续)       ←→   逻辑 token 位置 (0, 1, 2, 3, ...)
页表 page table               ←→   block_table: List[int]
物理帧号 (PFN)                ←→   物理 Block ID
进程创建 → 分配虚拟地址空间 + 建页表  ←→  请求开始 → allocate() + 建 block_table
缺页中断 → 按需分配新页帧    ←→   append_slot() → 按需分配新 Block
进程退出 → 归还页帧 ←→ free() → 归还 Block两者的核心思想完全相同:上层(进程/模型)看到的是连续的地址空间,底层实际存储可以是分散的物理块,中间用一张映射表(页表/block_table)做翻译。
block_table:逻辑位置到物理槽位的翻译
block_table 是一个整数列表,记录该序列占用的物理 Block ID,按逻辑顺序排列。
以 block_size=4(每个 Block 存 4 个 token 的 K/V)为例:
序列 A:已生成 6 个 token,token_ids = [t0, t1, t2, t3, t4, t5]

block_table = [7, 3]
               ↑   ↑
               逻辑Block[0]映射到物理Block 7
                   逻辑Block[1]映射到物理Block 3

地址翻译(translate_slot):
  token_pos=0 → block_idx=0, slot_in=0 → 物理槽位 = 7×4+0 = 28
  token_pos=1 → block_idx=0, slot_in=1 → 物理槽位 = 7×4+1 = 29
  token_pos=2 → block_idx=0, slot_in=2 → 物理槽位 = 7×4+2 = 30
  token_pos=3 → block_idx=0, slot_in=3 → 物理槽位 = 7×4+3 = 31
  token_pos=4 → block_idx=1, slot_in=0 → 物理槽位 = 3×4+0 = 12
  token_pos=5 → block_idx=1, slot_in=1 → 物理槽位 = 3×4+1 = 13

物理显存布局(KV Cache tensor 的槽位维度):
  槽位 ...
  槽位 12  ← 序列A 的 t4 的 K/V
  槽位 13  ← 序列A 的 t5 的 K/V
  槽位 ...
  槽位 28  ← 序列A 的 t0 的 K/V
  槽位 29  ← 序列A 的 t1 的 K/V
  槽位 30  ← 序列A 的 t2 的 K/V
  槽位 31  ← 序列A 的 t3 的 K/V
  槽位 ...

注意:Block 7(槽位28-31)和 Block 3(槽位12-15)在显存里并不相邻,
      但通过 block_table 查表,Attention 计算能正确找到所有 token 的 KV。
翻译公式(来自 block_manager.py):
block_idx        = token_pos // block_size   # 在 block_table 中的下标
slot_in_block    = token_pos  % block_size   # 在该 Block 内的偏移
physical_slot    = block_table[block_idx] * block_size + slot_in_block
translate_slot 在真实 vLLM 中的对应位置
translate_slot 是 Python 层的教学辅助函数,帮助你建立"逻辑位置 → 物理槽位"的直觉。在真实 vLLM 里,这个翻译不在 Python 层执行——Python 只负责把 block_table(整型数组)传给 GPU,翻译逻辑内嵌在 CUDA kernel 里:
教学版(本章):
  Python: translate_slot(block_table, token_pos) → physical_slot
  用途:演示翻译过程,建立直觉

真实 vLLM:
  Python: 把 block_tables tensor 传入 FlashAttention kernel
  GPU kernel 内部:physical_slot = block_tables[seq_idx][block_idx] * block_size + slot_in_block
  翻译在 GPU 上完成,Python 端不需要逐 token 查询
生产代码里对应的参数是 FlashAttention 的 paged_kv_block_table,或 vLLM 自定义 PagedAttention kernel 里的 block_tables tensor——逻辑完全相同,只是计算发生在 GPU kernel 内而非 Python 函数里。
BlockManager 的核心接口
BlockManager 管理所有物理 Block 的分配与回收,维护一个空闲 Block 队列:
BlockManager 内部状态
────────────────────────────────────────────────────
total_blocks = 10, block_size = 4

物理 Block 池:
  [Block(id=0, ref=0), Block(id=1, ref=0), ..., Block(id=9, ref=0)]
   ↑ 全部在 _free 队列中

_free 队列(deque):
[B0, B1, B2, B3, B4, B5, B6, B7, B8, B9] ← 先进先出allocate(num_blocks):从队列头取出指定数量的 Block,设置 ref_count=1,返回 Block ID 列表:
调用 allocate(2) 后:
  _free: [B2, B3, ..., B9]      ← B0、B1 被取出
  返回 block_table = [0, 1]
  Block 0: ref_count = 1
  Block 1: ref_count = 1
append_slot(block_table, token_count):生成阶段每新增一个 token,检查是否需要新 Block。如果当前 Block 的槽位不够,自动分配新 Block 追加到 block_table:
token_count=5, block_size=4 时:
  需要 Block 数 = ceil(5/4) = 2
  当前 block_table = [0, 1](已有 2 个)→ 不需要新分配

token_count=9 时:
  需要 Block 数 = ceil(9/4) = 3
  当前 block_table = [0, 1](只有 2 个)→ 分配 1 个新 Block
返回 block_table = [0, 1, 新Block_id]free(block_table):序列完成生成后,将所有 Block 的 ref_count 减 1,归零的 Block 放回 _free 队列。
ref_count:为什么引用计数?
Block 对象上有 ref_count 字段,free() 是"减引用"而不是"直接回收"。目前 PagedAttention:分页内存管理 里每个 Block 只被一个序列持有,ref_count 始终是 0 或 1,看起来多此一举。
这是为 Prefix Caching:相同前缀只算一次 的前缀缓存预留的机制:
前缀共享场景(Prefix Caching:相同前缀只算一次 会实现):

系统提示词(System Prompt):"你是一个有帮助的AI助手..."
  → 对应 Block [0, 1, 2](已计算并缓存)

请求 X:System Prompt + 用户问题A
  → block_table = [0, 1, 2, 3]    ← Block 0/1/2 共享
  → Block 0 的 ref_count = 2      ← 被系统和请求X共同引用

请求 Y:System Prompt + 用户问题B
  → block_table = [0, 1, 2, 4]    ← Block 0/1/2 共享
  → Block 0 的 ref_count = 3      ← 被系统、请求X、请求Y引用

请求 X 结束时:
  free([0, 1, 2, 3])
  → Block 0/1/2 的 ref_count 减 1(变为 2)→ 不回收,Block Y 还在用
  → Block 3 的 ref_count 变为 0 → 回收 ✅
有了 ref_count,多个序列可以安全地共享同一批物理 Block,只要还有序列在引用,Block 就不会被错误回收。
利用率提升的原因
run.py 中的示例演示了利用率的计算。以 8 个请求、max_len=50、avg_actual=30、block_size=16 为参数:
连续分配(旧方案):
  总预留 = 50 × 8 = 400 slots
  实际使用 = 30 × 8 = 240 slots
  利用率 = 240 / 400 = 60%
  问题:请求结束前那 20 slots 空着,但别人用不了

分页分配(本方案,block_size=16):
  每请求实际占用 = ceil(30/16) × 16 = 32 slots(多浪费 2 个尾部槽位)
  总占用 = 32 × 8 = 256 slots
  利用率 = 240 / 256 ≈ 94%
  额外浪费来源:每个序列最后一个 Block 的尾部最多空 block_size-1 个槽

提升:60% → 94%
原因:不再提前锁死 max_len 的空间,真正"用多少占多少"
block_size 越小,尾部浪费越少,但管理开销(Block 数量、block_table 长度)越大。block_size 越大,尾部浪费越多,但元数据开销小。典型实现(如 vLLM)使用 block_size=16 作为默认值,在两者之间取平衡。
engine.py 中 Attention 计算的教学简化
engine.py 里 block 的分配和释放逻辑是真实的,但 attention 计算直接使用 seq.token_ids,没有真正用到 block_table:
# 教学版:block_table 只参与分配/释放,attention 仍用完整 token_ids
logits, seq.past_key_values = self.model(
    torch.tensor(seq.token_ids), past_key_values=seq.past_key_values
)
真实 vLLM 的做法:attention kernel 直接接收 block_table,从分散在物理显存中的非连续 Block 里读取 KV Cache:
# 真实 vLLM:FlashAttention PagedAttention 接口
flash_attn_with_kvcache(
    Q,
    kv_cache,                      # 全局 KV Cache [total_blocks, block_size, heads, dim]
    block_table=seq.block_table,   # ← 告诉 kernel 去哪些物理 block 读 K/V
    ...
)
block_table 中的物理 Block ID 直接传入 GPU kernel,kernel 内部按 block_table[block_idx] * block_size + slot_in_block 计算物理地址, 一次 kernel 调用完成对所有非连续 Block 的 attention 计算。
把 block_table 真正接入 attention 需要 FlashAttention 的 PagedAttention 接口,将在 FlashAttention:SRAM-aware 注意力计算 引入。
代码结构
step12_paged_attention/
  block_manager.py   ← BlockManager + Block,本步核心新增
  engine.py          ← PagedAttentionEngine,集成 BlockManager
  scheduler.py       ← 复用 Continuous Batching 调度器 的 Scheduler(无修改)
  model.py           ← 复用 单请求 KV Cache 的 TinyTransformerWithKVCache(无修改)
  run.py             ← 演示 BlockManager 操作 + 利用率对比
engine.py 中集成 BlockManager 的关键逻辑:
# prefill 阶段:根据 prompt 长度一次性分配足够的 Block
needed = ceil(len(seq.token_ids) / block_size)
seq.block_table = block_manager.allocate(needed)

# decode 阶段:每新增一个 token,检查并按需追加 Block
seq.block_table = block_manager.append_slot(
    seq.block_table, len(seq.token_ids) + 1
)

# 序列完成:归还所有 Block
if seq.is_done:
    block_manager.free(seq.block_table)
注:本教学版用 past_key_values(Python 列表)实际存储 KV 向量,Block 管理体现在分配逻辑上。生产级实现(vLLM)会在一块连续的显存 tensor 上直接按物理槽位写入/读取 K/V,从而完全消除 Python 对象开销和显存拷贝。
运行
python run.py预期输出:
总 Block 数: 10,Block 大小: 4
初始空闲 Block 数: 10

分配 2 个 Block: [0, 1]
剩余空闲: 8

逻辑位置 → 物理槽位翻译:
  逻辑位置 0 → Block[0]=0 slot 0 → 物理槽位 0
  逻辑位置 1 → Block[0]=0 slot 1 → 物理槽位 1
  逻辑位置 2 → Block[0]=0 slot 2 → 物理槽位 2
  逻辑位置 3 → Block[0]=0 slot 3 → 物理槽位 3
  逻辑位置 4 → Block[1]=1 slot 0 → 物理槽位 4
  逻辑位置 5 → Block[1]=1 slot 1 → 物理槽位 5
  逻辑位置 6 → Block[1]=1 slot 2 → 物理槽位 6
  逻辑位置 7 → Block[1]=1 slot 3 → 物理槽位 7

释放后空闲: 10

=======================================================
显存利用率:连续分配 vs 分页分配
=======================================================
  连续分配: 每请求预留 50 slots | 利用率 60%
  分页分配: 按需分配 Block(大小=16)| 利用率 94%

  提升: 60% → 94%  ✅

✅ step12_paged_attention 通过
下一步
PagedAttention:分页内存管理 解决了单序列的显存碎片问题,但还有一类浪费没有处理:相同前缀被重复计算。
多个请求通常共享同一段系统提示词(System Prompt),每次请求都要重新计算这段 prompt 的 KV Cache,是纯粹的重复计算和显存重复占用。
Prefix Caching:相同前缀只算一次 将在 ref_count 机制的基础上,实现前缀缓存(Prefix Caching):
- 对于内容相同的 Block,只保留一份物理拷贝
- 通过
ref_count让多个序列共享这些 Block - 新请求到来时,如果前缀已缓存,直接复用 block_table 中的物理 Block ID,跳过 prefill 计算